Datenqualitäts-Benchmark
Der Blick in Ihre Trainingsdaten.
Ein gemessener Bericht für jeden Text- oder Code-Datensatz, vor und nach der Aufbereitung, in einem Dokument.
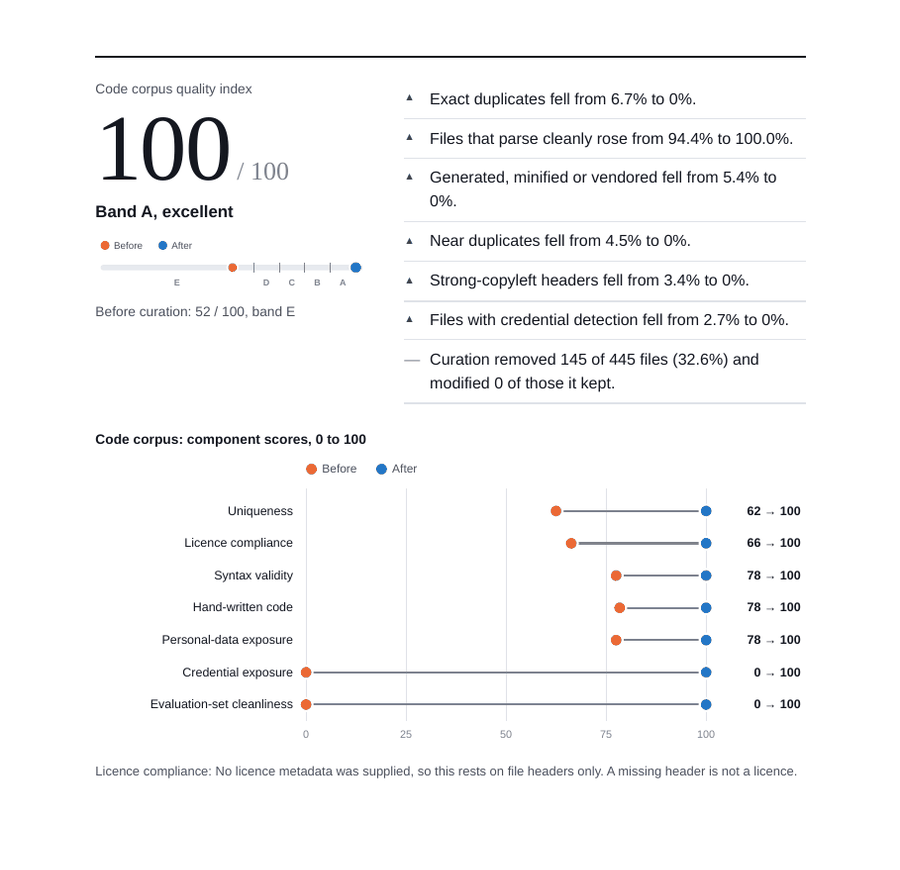
Eine Seite aus einem Bericht zu synthetischen Testdaten mit eingebauten Fehlern. Die Zahlen stammen nicht aus einem Kundendatensatz.
Was gemessen wird
Text und Code bekommen eigene Prüfungen.
Eine defekte Quelldatei, ein geleakter Schlüssel oder ein Copyleft-Header zählen bei Code. Eine falsche Sprachangabe oder ein beschädigter Scan zählen bei Text.
Text-Datensätze
- Bestandsaufnahme: Dokumente, Tokens, Länge, Sprach- und Fachgebietsmix
- Exakte und nahezu gleiche Duplikate
- Spracherkennung im Abgleich mit der gelieferten Angabe
- Lizenzmetadaten im Abgleich mit Ihrer Lizenzrichtlinie
- Strukturelle Qualität: Wiederholungen, Kodierungsfehler, Fragmente
- Erkannte personenbezogene Daten: E-Mail, Telefon, IBAN, Zahlungskarte, IP-Adresse
- Überschneidung mit Evaluierungsdaten
Code-Datensätze
- Bestandsaufnahme nach Programmiersprache: Dateien, Tokens, Zeilen
- Exakt und nahezu doppelte Dateien
- Syntaxgültigkeit: Anteil der Dateien, die fehlerfrei geparst werden
- Lizenz-Header, einschließlich Copyleft-Anteil
- Geleakte Zugangsdaten: Schlüssel, Tokens, fest kodierte Passwörter
- Generierte, minifizierte und eingebundene Fremddateien
- Überschneidung mit Code-Evaluierungsdaten
Der Qualitätsindex
Eine Zahl mit offengelegtem Rechenweg.
Jede Prüfung macht aus einer gemessenen Fehlerrate einen Wert von 0 bis 100, gemessen an einer angegebenen Toleranz. Der Index ist der gewichtete Mittelwert, angegeben in Stufen von A bis E.
Toleranzen und Gewichte stehen in jedem Bericht. Der Index fasst die Messungen zusammen. Er ist keine Garantie dafür, wie ein mit den Daten trainiertes Modell abschneidet.
- A
- Sehr gut · 90 und mehr
- B
- Gut · 80 bis 89
- C
- Befriedigend · 70 bis 79
- D
- Schwach · 60 bis 69
- E
- Mangelhaft · unter 60
So entsteht der Bericht
Fünf Regeln für jeden Bericht.
Nur Zahlen
Anzahlen, Raten und Verteilungen. Kein Text aus Ihren Daten, und kleine Gruppen werden zusammengefasst, damit keine Zahl auf eine Handvoll Dokumente zeigt.
Lokale Verarbeitung
Die Messung läuft auf unserem Rechner oder in Ihrer Umgebung. Kein Inhalt des Datensatzes geht an einen externen Dienst.
Reproduzierbar
Tool-Version, Einstellungen, Tokenizer und ein Fingerabdruck der Daten werden festgehalten. Dieselbe Eingabe ergibt dieselben Zahlen.
Null ist kein Beweis
Prüfungen berichten, was erkannt wurde. Eine Null wird nie als Beweis dargestellt, dass nichts vorhanden ist.
Ihre eigenen Evaluierungsdaten
Ihr eigener Benchmark kann auf Leakage geprüft werden, über einen gehashten Index, der sich nicht in Text zurückverwandeln lässt.
Wann es hilft
Vier Momente zum Messen.
Bevor Sie Daten kaufen
Prüfen Sie die Probe eines Anbieters gegen das, was das Angebot verspricht.
Bevor Sie trainieren
Finden Sie Duplikate, personenbezogene Daten und Benchmark-Leakage, solange sie noch günstig zu beheben sind.
Nach der Aufbereitung
Zeigen Sie in Zahlen, was die Bereinigung verändert hat, für Ihr Team oder für Prüfer.
Wenn Sie Daten verkaufen
Geben Sie Käufern einen unabhängigen Qualitätsbericht zu Ihrer Data Card.
Lieferung
Was Sie erhalten.
Senden oder bereitstellen
Sie senden den Datensatz unter NDA, oder wir messen in Ihrer Umgebung.
Wir messen
CurateLM führt die Messung durch. Das Tool selbst wird nicht übergeben.
Sie erhalten den Bericht
Einen PDF-Bericht, eine HTML-Version und eine JSON-Datei mit allen Zahlen.
Fragen zum Benchmark.
Enthält der Bericht Daten von uns?
Nein. Er enthält nur aggregierte Zahlen. Erkannte E-Mail-Adressen, Schlüssel und ähnliche Werte werden gezählt und nie gespeichert.
Können Sie unsere Daten gegen unseren privaten Benchmark prüfen?
Ja. Ihr Evaluierungsdatensatz wird auf dem Rechner, der die Messung durchführt, in einen gehashten Index umgewandelt. Der Index enthält keinen Benchmark-Text.
Ist ein guter Index eine Garantie für Modellqualität?
Nein. Der Bericht gibt an, was wie gemessen wurde. Er ist keine Rechtsberatung, kein Lizenzgutachten und keine Vorhersage der Modellleistung.
Welche Programmiersprachen können auf Syntax geprüft werden?
Mehr als zwanzig, darunter Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL und Fortran. Sprachen ohne Parser werden als nicht geprüft ausgewiesen, nicht als fehlgeschlagen.
Gibt es den Benchmark auch ohne Datenkauf oder Aufbereitung?
Ja. Der Benchmark ist eine eigenständige Leistung. Bei Aufbereitungsprojekten ist er als Vorher-nachher-Bericht enthalten.
Lassen Sie einen Datensatz messen.
Sagen Sie uns, ob es um Text, Code oder beides geht, und wie groß er ungefähr ist.