Benchmark de calidad de datos
Sepa qué hay en sus datos de entrenamiento.
Un informe medido para cualquier conjunto de datos de texto o código, antes y después de la curación, en un solo documento.
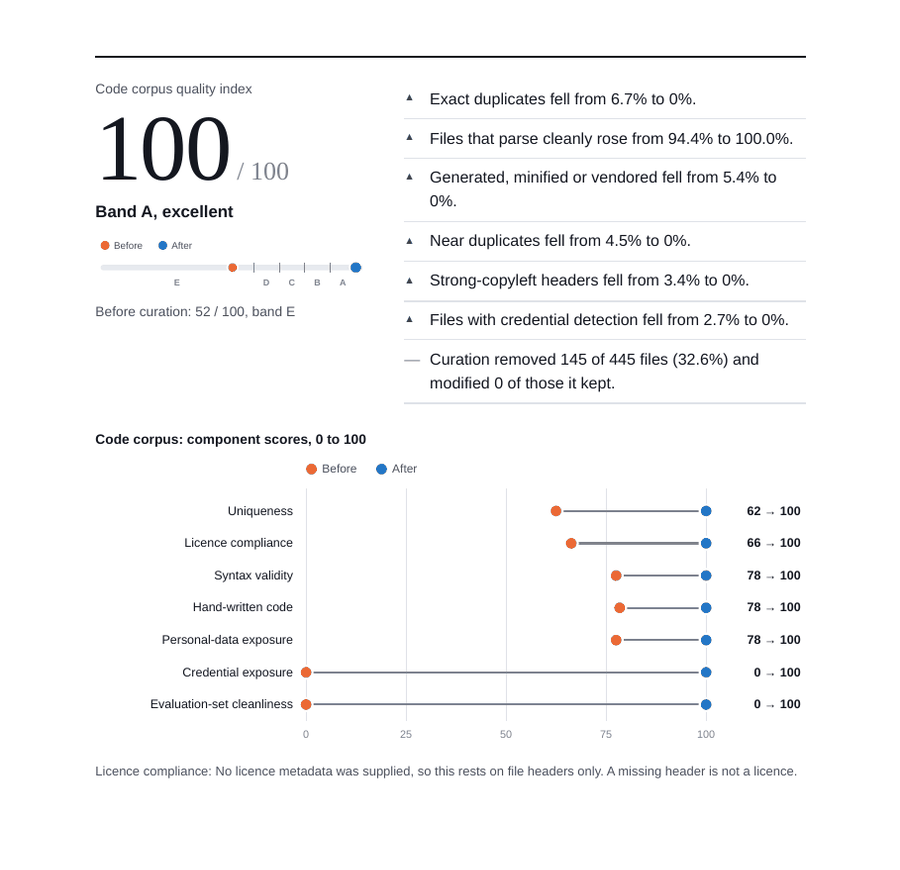
Una página de un informe sobre datos de prueba sintéticos con defectos introducidos a propósito. Las cifras no proceden de un conjunto de datos de un cliente.
Qué se mide
El texto y el código tienen sus propias comprobaciones.
Un archivo fuente roto, una clave filtrada o una cabecera copyleft importan en el código. Una etiqueta de idioma errónea o un escaneo dañado importan en el texto.
Conjuntos de datos de texto
- Inventario: documentos, tokens, longitud, combinación de idiomas y materias
- Duplicados exactos y casi duplicados
- Identificación del idioma frente a la etiqueta proporcionada
- Metadatos de licencia frente a su política de licencias
- Calidad estructural: repetición, errores de codificación, fragmentos
- Datos personales detectados: correo, teléfono, IBAN, tarjeta de pago, dirección IP
- Superposición con conjuntos de evaluación
Conjuntos de datos de código
- Inventario por lenguaje de programación: archivos, tokens, líneas
- Archivos duplicados exactos o casi idénticos
- Validez sintáctica: proporción de archivos que se analizan sin errores
- Cabeceras de licencia, incluida la proporción copyleft
- Credenciales filtradas: claves, tokens, contraseñas incrustadas
- Archivos generados, minificados y de terceros incluidos
- Superposición con conjuntos de evaluación de código
El índice de calidad
Una cifra con el cálculo a la vista.
Cada comprobación convierte una tasa de defectos medida en una puntuación de 0 a 100 frente a una tolerancia declarada. El índice es la media ponderada, expresada en niveles de la A a la E.
Las tolerancias y ponderaciones figuran en cada informe. El índice resume las mediciones. No garantiza el rendimiento de un modelo entrenado con esos datos.
- A
- Excelente · 90 o más
- B
- Bueno · 80 a 89
- C
- Aceptable · 70 a 79
- D
- Débil · 60 a 69
- E
- Deficiente · menos de 60
Cómo se elabora el informe
Cinco reglas que cumple cada informe.
Solo cifras
Recuentos, tasas y distribuciones. Ningún texto de sus datos, y los grupos pequeños se agrupan para que ninguna cifra señale a un puñado de documentos.
Procesamiento local
La medición se ejecuta en nuestra máquina o dentro de su entorno. Ningún contenido del conjunto de datos se envía a un servicio externo.
Reproducible
Se registran la versión de la herramienta, la configuración, el tokenizador y una huella de los datos. La misma entrada da las mismas cifras.
Cero no es una prueba
Los análisis informan de lo que se detectó. Un cero nunca se presenta como prueba de que no hay nada.
Sus conjuntos de evaluación privados
Su propio benchmark puede comprobarse frente a fugas, mediante un índice con hash que no puede volver a convertirse en texto.
Cuándo ayuda
Cuatro momentos para medir.
Antes de comprar datos
Contraste la muestra de un proveedor con lo que promete la oferta.
Antes de entrenar
Encuentre duplicados, datos personales y fugas de benchmark mientras aún es barato corregirlos.
Después de la curación
Muestre en cifras lo que cambió la limpieza, para su equipo o para un auditor.
Cuando vende datos
Entregue a los compradores un informe de calidad independiente junto a su ficha de datos.
Entrega
Lo que recibe.
Enviar o alojar
Usted envía el conjunto de datos bajo NDA, o lo medimos dentro de su entorno.
Medimos
CurateLM realiza la medición. La herramienta en sí no se entrega.
Recibe el informe
Un informe en PDF, una versión HTML y un archivo JSON con todas las cifras.
Preguntas sobre el benchmark.
¿Contiene el informe alguno de nuestros datos?
No. Solo contiene cifras agregadas. Las direcciones de correo, claves y valores similares detectados se cuentan y nunca se almacenan.
¿Pueden comprobar nuestros datos frente a nuestro propio benchmark privado?
Sí. Su conjunto de evaluación se convierte en un índice con hash en la máquina que realiza la medición. El índice no contiene texto del benchmark.
¿Un buen índice garantiza la calidad del modelo?
No. El informe indica qué se midió y cómo. No es asesoramiento jurídico, ni un dictamen sobre licencias, ni una predicción del rendimiento del modelo.
¿Qué lenguajes de programación se pueden comprobar sintácticamente?
Más de veinte, entre ellos Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL y Fortran. Los lenguajes sin analizador se indican como no comprobados, no como fallidos.
¿Podemos contratar el benchmark sin comprar datos ni curación?
Sí. El benchmark es un servicio independiente. También se incluye en los proyectos de curación como informe de antes y después.
Haga medir un conjunto de datos.
Díganos si es texto, código o ambos, y qué tamaño tiene aproximadamente.