Benchmark de qualité des données
Sachez ce que contiennent vos données d'entraînement.
Un rapport mesuré pour tout jeu de données texte ou code, avant et après curation, en un seul document.
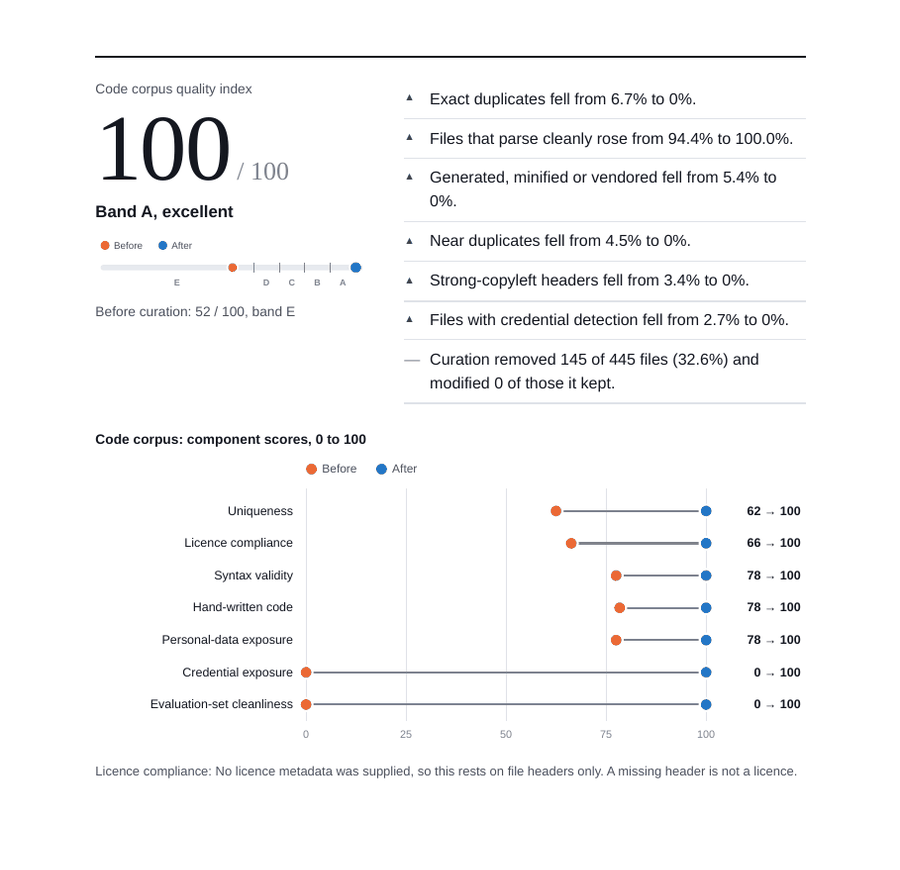
Une page d'un rapport sur des données de test synthétiques comportant des défauts introduits volontairement. Les chiffres ne proviennent pas d'un jeu de données client.
Ce qui est mesuré
Le texte et le code ont leurs propres contrôles.
Un fichier source cassé, une clé divulguée ou un en-tête copyleft comptent pour le code. Une étiquette de langue erronée ou un scan endommagé comptent pour le texte.
Jeux de données texte
- Inventaire : documents, tokens, longueur, répartition des langues et des domaines
- Doublons exacts et quasi-doublons
- Identification de la langue face à l'étiquette fournie
- Métadonnées de licence face à votre politique de licences
- Qualité structurelle : répétitions, erreurs d'encodage, fragments
- Données personnelles détectées : e-mail, téléphone, IBAN, carte de paiement, adresse IP
- Recouvrement avec les jeux d'évaluation
Jeux de données code
- Inventaire par langage de programmation : fichiers, tokens, lignes
- Fichiers en double, exacts ou quasi identiques
- Validité syntaxique : part des fichiers analysés sans erreur
- En-têtes de licence, y compris la part copyleft
- Identifiants divulgués : clés, tokens, mots de passe en dur
- Fichiers générés, minifiés et tiers intégrés
- Recouvrement avec les jeux d'évaluation de code
L'indice de qualité
Un seul chiffre avec le calcul détaillé.
Chaque contrôle convertit un taux de défaut mesuré en score de 0 à 100 par rapport à une tolérance indiquée. L'indice est la moyenne pondérée, exprimée en niveaux de A à E.
Tolérances et pondérations figurent dans chaque rapport. L'indice résume les mesures. Il ne garantit pas les performances d'un modèle entraîné sur ces données.
- A
- Excellent · 90 et plus
- B
- Bon · 80 à 89
- C
- Correct · 70 à 79
- D
- Faible · 60 à 69
- E
- Insuffisant · moins de 60
Comment le rapport est établi
Cinq règles que chaque rapport respecte.
Uniquement des chiffres
Comptages, taux et distributions. Aucun texte de vos données, et les petits groupes sont regroupés pour qu'aucun chiffre ne désigne une poignée de documents.
Traitement local
La mesure s'exécute sur notre machine ou dans votre environnement. Aucun contenu du jeu de données n'est envoyé à un service externe.
Reproductible
Version de l'outil, paramètres, tokenizer et empreinte des données sont consignés. Les mêmes entrées donnent les mêmes chiffres.
Zéro n'est pas une preuve
Les analyses indiquent ce qui a été détecté. Un zéro n'est jamais présenté comme la preuve que rien n'est présent.
Vos jeux d'évaluation privés
Votre propre benchmark peut être contrôlé contre les fuites, via un index haché qui ne peut pas être retransformé en texte.
Quand c'est utile
Quatre moments pour mesurer.
Avant d'acheter des données
Vérifiez l'échantillon d'un fournisseur au regard de ce que promet l'offre.
Avant d'entraîner
Trouvez doublons, données personnelles et fuites de benchmark tant qu'ils sont encore peu coûteux à corriger.
Après la curation
Montrez en chiffres ce que le nettoyage a changé, pour votre équipe ou pour un auditeur.
Quand vous vendez des données
Remettez aux acheteurs un rapport de qualité indépendant avec votre fiche de données.
Livraison
Ce que vous recevez.
Envoyer ou héberger
Vous envoyez le jeu de données sous NDA, ou nous le mesurons dans votre environnement.
Nous mesurons
CurateLM réalise la mesure. L'outil lui-même n'est pas remis.
Vous recevez le rapport
Un rapport PDF, une version HTML et un fichier JSON contenant tous les chiffres.
Questions sur le benchmark.
Le rapport contient-il nos données ?
Non. Il ne contient que des chiffres agrégés. Les adresses e-mail, clés et valeurs similaires détectées sont comptées et jamais stockées.
Pouvez-vous vérifier nos données par rapport à notre propre benchmark privé ?
Oui. Votre jeu d'évaluation est converti en index haché sur la machine qui effectue la mesure. L'index ne contient aucun texte du benchmark.
Un bon indice garantit-il la qualité du modèle ?
Non. Le rapport indique ce qui a été mesuré et comment. Ce n'est ni un conseil juridique, ni un avis sur les licences, ni une prédiction des performances du modèle.
Quels langages de programmation peuvent être vérifiés syntaxiquement ?
Plus de vingt, dont Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL et Fortran. Les langages sans analyseur sont indiqués comme non vérifiés, pas comme en échec.
Peut-on obtenir le benchmark sans acheter de données ni de curation ?
Oui. Le benchmark est un service à part entière. Il est aussi inclus dans les projets de curation sous forme de rapport avant/après.
Faites mesurer un jeu de données.
Dites-nous s'il s'agit de texte, de code ou des deux, et quelle est sa taille approximative.