Benchmark della qualità dei dati
Sappiate cosa c'è nei vostri dati di addestramento.
Un report misurato per qualsiasi dataset di testo o codice, prima e dopo la curation, in un unico documento.
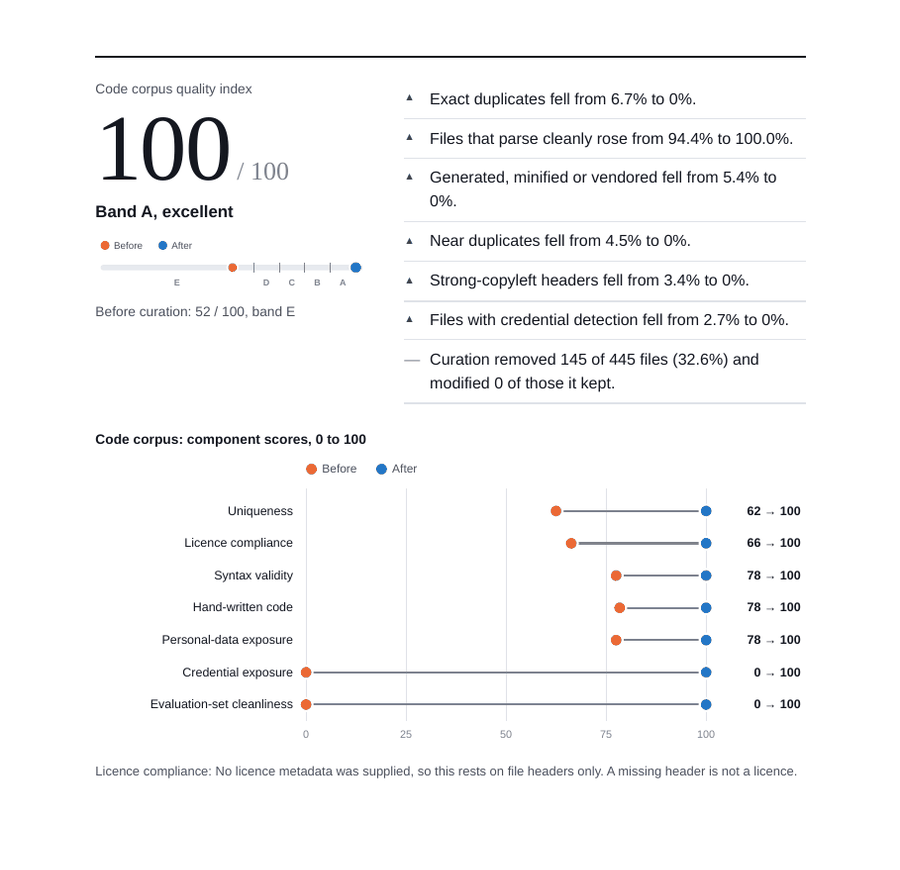
Una pagina di un report su dati di test sintetici con difetti inseriti di proposito. Le cifre non provengono da un dataset di un cliente.
Cosa viene misurato
Testo e codice hanno i loro controlli.
Un file sorgente rotto, una chiave esposta o un'intestazione copyleft contano nel codice. Un'etichetta di lingua sbagliata o una scansione danneggiata contano nel testo.
Dataset di testo
- Inventario: documenti, token, lunghezza, composizione di lingue e materie
- Duplicati esatti e quasi-duplicati
- Identificazione della lingua rispetto all'etichetta fornita
- Metadati di licenza rispetto alla vostra politica delle licenze
- Qualità strutturale: ripetizioni, errori di codifica, frammenti
- Dati personali rilevati: e-mail, telefono, IBAN, carta di pagamento, indirizzo IP
- Sovrapposizione con i set di valutazione
Dataset di codice
- Inventario per linguaggio di programmazione: file, token, righe
- File duplicati esatti o quasi identici
- Validità sintattica: quota di file analizzati senza errori
- Intestazioni di licenza, compresa la quota copyleft
- Credenziali esposte: chiavi, token, password nel codice
- File generati, minificati e di terze parti inclusi
- Sovrapposizione con i set di valutazione del codice
L'indice di qualità
Un solo numero con il calcolo in vista.
Ogni controllo trasforma un tasso di difetti misurato in un punteggio da 0 a 100 rispetto a una tolleranza dichiarata. L'indice è la media ponderata, espressa in fasce da A a E.
Tolleranze e pesi sono riportati in ogni report. L'indice riassume le misurazioni. Non garantisce le prestazioni di un modello addestrato su quei dati.
- A
- Eccellente · 90 e oltre
- B
- Buono · da 80 a 89
- C
- Discreto · da 70 a 79
- D
- Debole · da 60 a 69
- E
- Scarso · sotto 60
Come nasce il report
Cinque regole che ogni report rispetta.
Solo numeri
Conteggi, tassi e distribuzioni. Nessun testo dei vostri dati, e i gruppi piccoli vengono accorpati perché nessuna cifra indichi una manciata di documenti.
Elaborazione locale
La misurazione gira sulla nostra macchina o nel vostro ambiente. Nessun contenuto del dataset viene inviato a un servizio esterno.
Riproducibile
Versione dello strumento, impostazioni, tokenizer e impronta dei dati vengono registrati. Lo stesso input dà le stesse cifre.
Zero non è una prova
Le analisi riportano ciò che è stato rilevato. Uno zero non viene mai presentato come prova che non ci sia nulla.
I vostri set di valutazione privati
Il vostro benchmark può essere controllato contro le fughe di dati, tramite un indice con hash che non può essere ritrasformato in testo.
Quando serve
Quattro momenti per misurare.
Prima di acquistare dati
Confrontate il campione di un fornitore con ciò che l'offerta promette.
Prima di addestrare
Trovate duplicati, dati personali e fughe del benchmark finché correggerli costa ancora poco.
Dopo la curation
Mostrate in cifre cosa ha cambiato la pulizia, per il vostro team o per un revisore.
Quando vendete dati
Date agli acquirenti un report di qualità indipendente accanto alla vostra scheda dati.
Consegna
Cosa ricevete.
Inviare o ospitare
Ci inviate il dataset sotto NDA, oppure lo misuriamo nel vostro ambiente.
Misuriamo
CurateLM esegue la misurazione. Lo strumento in sé non viene consegnato.
Ricevete il report
Un report in PDF, una versione HTML e un file JSON con tutte le cifre.
Domande sul benchmark.
Il report contiene qualcosa dei nostri dati?
No. Contiene solo cifre aggregate. Indirizzi e-mail, chiavi e valori simili rilevati vengono contati e mai memorizzati.
Potete verificare i nostri dati rispetto al nostro benchmark privato?
Sì. Il vostro set di valutazione viene convertito in un indice con hash sulla macchina che esegue la misurazione. L'indice non contiene testo del benchmark.
Un buon indice garantisce la qualità del modello?
No. Il report indica cosa è stato misurato e come. Non è una consulenza legale, né un parere sulle licenze, né una previsione delle prestazioni del modello.
Quali linguaggi di programmazione possono essere verificati per la sintassi?
Più di venti, tra cui Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL e Fortran. I linguaggi senza parser vengono indicati come non verificati, non come falliti.
Possiamo avere il benchmark senza acquistare dati o curation?
Sì. Il benchmark è un servizio a sé. È incluso anche nei progetti di curation come report prima/dopo.
Fate misurare un dataset.
Diteci se si tratta di testo, codice o entrambi, e quanto è grande all'incirca.