Benchmark voor datakwaliteit
Weet wat er in uw trainingsdata zit.
Een gemeten rapport voor elke tekst- of codedataset, voor en na curatie, in één document.
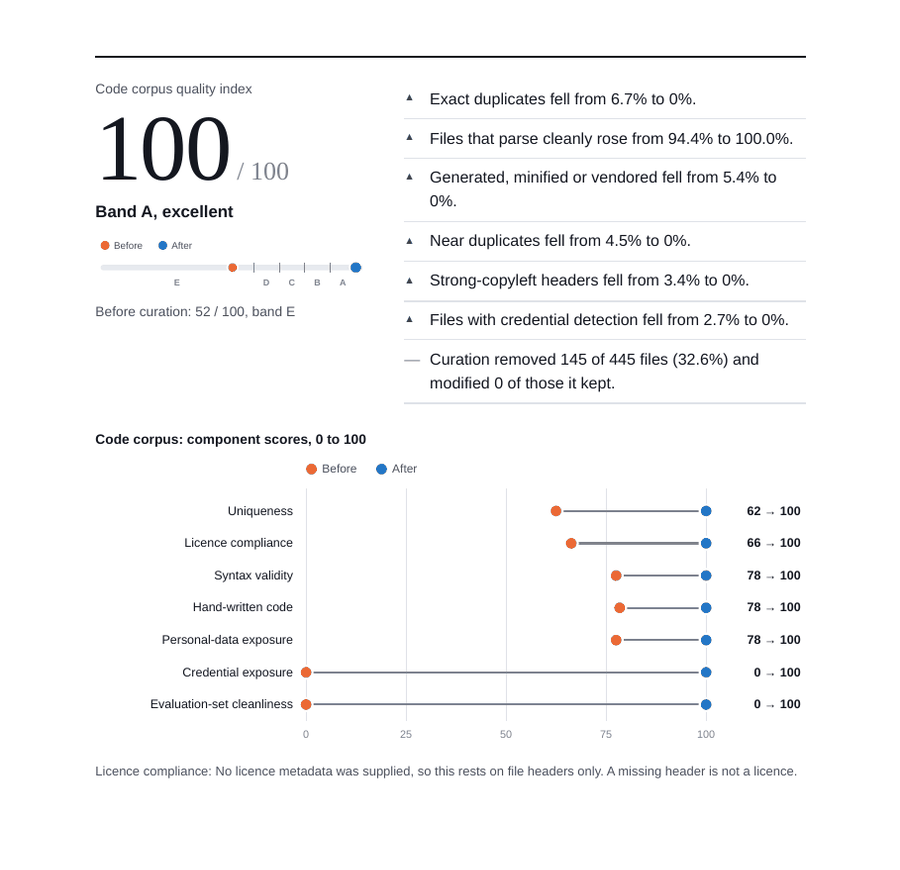
Een pagina uit een rapport over synthetische testdata met bewust ingebouwde fouten. De cijfers komen niet uit een klantdataset.
Wat er gemeten wordt
Tekst en code krijgen hun eigen controles.
Een kapot bronbestand, een gelekte sleutel of een copyleft-header telt bij code. Een verkeerd taallabel of een beschadigde scan telt bij tekst.
Tekstdatasets
- Inventaris: documenten, tokens, lengte, mix van talen en vakgebieden
- Exacte en bijna-duplicaten
- Taalidentificatie tegenover het meegeleverde label
- Licentiemetadata tegenover uw licentiebeleid
- Structurele kwaliteit: herhaling, coderingsfouten, fragmenten
- Gedetecteerde persoonsgegevens: e-mail, telefoon, IBAN, betaalkaart, IP-adres
- Overlap met evaluatiesets
Codedatasets
- Inventaris per programmeertaal: bestanden, tokens, regels
- Exacte en bijna-dubbele bestanden
- Syntaxgeldigheid: aandeel bestanden dat zonder fouten wordt geparsed
- Licentieheaders, inclusief het copyleft-aandeel
- Gelekte inloggegevens: sleutels, tokens, hardgecodeerde wachtwoorden
- Gegenereerde, geminificeerde en meegeleverde externe bestanden
- Overlap met code-evaluatiesets
De kwaliteitsindex
Eén getal met de berekening erbij.
Elke controle zet een gemeten foutpercentage om in een score van 0 tot 100 ten opzichte van een opgegeven tolerantie. De index is het gewogen gemiddelde, uitgedrukt in klassen van A tot E.
Toleranties en gewichten staan in elk rapport. De index vat de metingen samen. Het is geen garantie voor hoe een model presteert dat op de data is getraind.
- A
- Uitstekend · 90 en hoger
- B
- Goed · 80 tot 89
- C
- Redelijk · 70 tot 79
- D
- Zwak · 60 tot 69
- E
- Slecht · onder 60
Hoe het rapport tot stand komt
Vijf regels die elk rapport volgt.
Alleen cijfers
Aantallen, percentages en verdelingen. Geen tekst uit uw data, en kleine groepen worden samengevoegd zodat geen enkel cijfer naar een handvol documenten wijst.
Lokale verwerking
De meting draait op onze machine of in uw omgeving. Er gaat geen inhoud van de dataset naar een externe dienst.
Reproduceerbaar
Toolversie, instellingen, tokenizer en een vingerafdruk van de data worden vastgelegd. Dezelfde invoer geeft dezelfde cijfers.
Nul is geen bewijs
Scans rapporteren wat is gedetecteerd. Een nul wordt nooit gepresenteerd als bewijs dat er niets is.
Uw eigen evaluatiesets
Uw eigen benchmark kan op lekken worden gecontroleerd, via een gehashte index die niet terug naar tekst kan worden omgezet.
Wanneer het helpt
Vier momenten om te meten.
Voordat u data koopt
Controleer de steekproef van een leverancier tegen wat het aanbod belooft.
Voordat u traint
Vind duplicaten, persoonsgegevens en benchmarklekken zolang ze nog goedkoop te herstellen zijn.
Na curatie
Laat in cijfers zien wat het opschonen heeft veranderd, voor uw eigen team of voor een auditor.
Wanneer u data verkoopt
Geef kopers een onafhankelijk kwaliteitsrapport naast uw datakaart.
Levering
Wat u ontvangt.
Sturen of hosten
U stuurt de dataset onder NDA, of wij meten in uw omgeving.
Wij meten
CurateLM voert de meting uit. De tool zelf wordt niet overgedragen.
U ontvangt het rapport
Een PDF-rapport, een HTML-versie en een JSON-bestand met alle cijfers.
Vragen over de benchmark.
Bevat het rapport iets van onze data?
Nee. Het bevat alleen geaggregeerde cijfers. Gedetecteerde e-mailadressen, sleutels en vergelijkbare waarden worden geteld en nooit opgeslagen.
Kunnen jullie onze data toetsen aan onze eigen privébenchmark?
Ja. Uw evaluatieset wordt omgezet in een gehashte index op de machine die de meting uitvoert. De index bevat geen benchmarktekst.
Is een goede index een garantie voor modelkwaliteit?
Nee. Het rapport vermeldt wat er is gemeten en hoe. Het is geen juridisch advies, geen licentieoordeel en geen voorspelling van modelprestaties.
Welke programmeertalen kunnen op syntax worden gecontroleerd?
Meer dan twintig, waaronder Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL en Fortran. Talen zonder parser worden als niet gecontroleerd gemeld, niet als mislukt.
Kunnen we de benchmark krijgen zonder data of curatie te kopen?
Ja. De benchmark is een aparte dienst. Bij curatieprojecten is hij ook inbegrepen als voor-en-na-rapport.
Laat een dataset meten.
Vertel ons of het om tekst, code of beide gaat, en hoe groot het ongeveer is.