Benchmark jakości danych
Sprawdź zawartość swoich danych treningowych.
Zmierzony raport dla dowolnego zbioru tekstu lub kodu, przed kuracją i po niej, w jednym dokumencie.
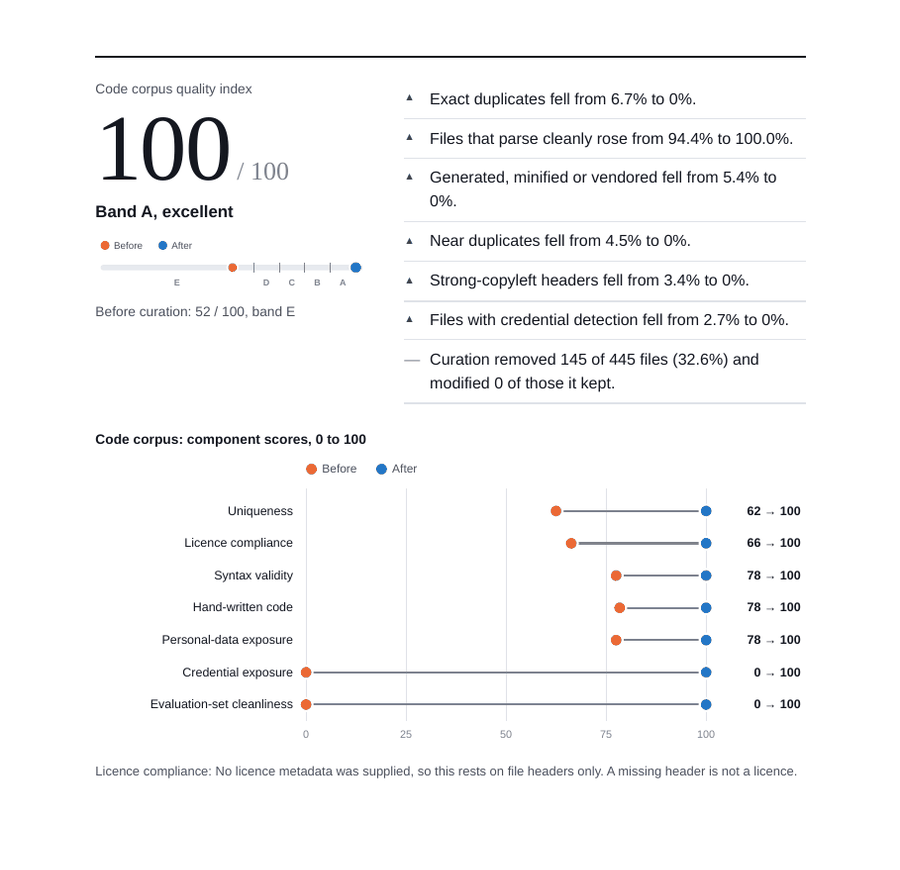
Strona raportu dotyczącego syntetycznych danych testowych z celowo wprowadzonymi błędami. Liczby nie pochodzą ze zbioru danych klienta.
Co jest mierzone
Tekst i kod mają własne kontrole.
W kodzie liczy się uszkodzony plik źródłowy, wyciekły klucz lub nagłówek copyleft. W tekście liczy się błędna etykieta języka lub uszkodzony skan.
Zbiory tekstowe
- Inwentaryzacja: dokumenty, tokeny, długość, struktura języków i dziedzin
- Dokładne i niemal dokładne duplikaty
- Identyfikacja języka względem dostarczonej etykiety
- Metadane licencji względem Twojej polityki licencji
- Jakość strukturalna: powtórzenia, błędy kodowania, fragmenty
- Wykryte dane osobowe: e-mail, telefon, IBAN, karta płatnicza, adres IP
- Nakładanie się ze zbiorami ewaluacyjnymi
Zbiory kodu
- Inwentaryzacja według języka programowania: pliki, tokeny, linie
- Pliki zduplikowane dokładnie lub niemal dokładnie
- Poprawność składni: odsetek plików parsowanych bez błędów
- Nagłówki licencji, w tym udział copyleft
- Wyciekłe dane uwierzytelniające: klucze, tokeny, hasła zapisane w kodzie
- Pliki generowane, zminifikowane i dołączone zewnętrzne
- Nakładanie się ze zbiorami ewaluacyjnymi kodu
Wskaźnik jakości
Jedna liczba z pokazanym obliczeniem.
Każda kontrola zamienia zmierzony odsetek defektów na wynik od 0 do 100 względem podanej tolerancji. Wskaźnik to średnia ważona, podawana w klasach od A do E.
Tolerancje i wagi są podane w każdym raporcie. Wskaźnik podsumowuje pomiary. Nie gwarantuje, jak będzie działać model wytrenowany na tych danych.
- A
- Doskonały · 90 i więcej
- B
- Dobry · od 80 do 89
- C
- Dostateczny · od 70 do 79
- D
- Słaby · od 60 do 69
- E
- Niedostateczny · poniżej 60
Jak powstaje raport
Pięć zasad każdego raportu.
Tylko liczby
Liczebności, wskaźniki i rozkłady. Żadnego tekstu z Twoich danych, a małe grupy są łączone, by żadna liczba nie wskazywała garstki dokumentów.
Przetwarzanie lokalne
Pomiar działa na naszej maszynie lub w Twoim środowisku. Żadna treść zbioru danych nie trafia do zewnętrznej usługi.
Powtarzalność
Zapisujemy wersję narzędzia, ustawienia, tokenizer i odcisk danych. Te same dane wejściowe dają te same liczby.
Zero to nie dowód
Skanowanie raportuje to, co wykryto. Zero nigdy nie jest przedstawiane jako dowód, że niczego nie ma.
Twoje prywatne zbiory ewaluacyjne
Twój własny benchmark można sprawdzić pod kątem wycieku za pomocą zahashowanego indeksu, którego nie da się z powrotem zamienić na tekst.
Kiedy to pomaga
Cztery momenty na pomiar.
Zanim kupisz dane
Sprawdź próbkę dostawcy pod kątem tego, co obiecuje oferta.
Zanim zaczniesz trening
Znajdź duplikaty, dane osobowe i wycieki benchmarków, póki ich usunięcie jest jeszcze tanie.
Po kuracji
Pokaż w liczbach, co zmieniło czyszczenie, swojemu zespołowi lub audytorowi.
Gdy sprzedajesz dane
Daj kupującym niezależny raport jakości obok karty danych.
Dostawa
Co otrzymujesz.
Wyślij lub udostępnij
Przesyłasz zbiór danych w ramach NDA albo mierzymy go w Twoim środowisku.
Mierzymy
Pomiar wykonuje CurateLM. Samo narzędzie nie jest przekazywane.
Otrzymujesz raport
Raport PDF, wersję HTML i plik JSON ze wszystkimi liczbami.
Pytania o benchmark.
Czy raport zawiera jakiekolwiek nasze dane?
Nie. Zawiera wyłącznie zagregowane liczby. Wykryte adresy e-mail, klucze i podobne wartości są liczone i nigdy nie są przechowywane.
Czy możecie sprawdzić nasze dane względem naszego prywatnego benchmarku?
Tak. Twój zbiór ewaluacyjny jest zamieniany w zahashowany indeks na maszynie wykonującej pomiar. Indeks nie zawiera tekstu benchmarku.
Czy dobry wskaźnik gwarantuje jakość modelu?
Nie. Raport podaje, co i jak zmierzono. Nie jest poradą prawną, opinią licencyjną ani prognozą działania modelu.
Które języki programowania można sprawdzić pod kątem składni?
Ponad dwadzieścia, w tym Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL i Fortran. Języki bez parsera są oznaczane jako niesprawdzone, a nie jako błędne.
Czy możemy zamówić benchmark bez kupowania danych lub kuracji?
Tak. Benchmark to osobna usługa. Jest też częścią projektów kuracji jako raport „przed i po”.
Zleć pomiar zbioru danych.
Powiedz nam, czy chodzi o tekst, kod czy oba, i jak duży jest mniej więcej zbiór.